


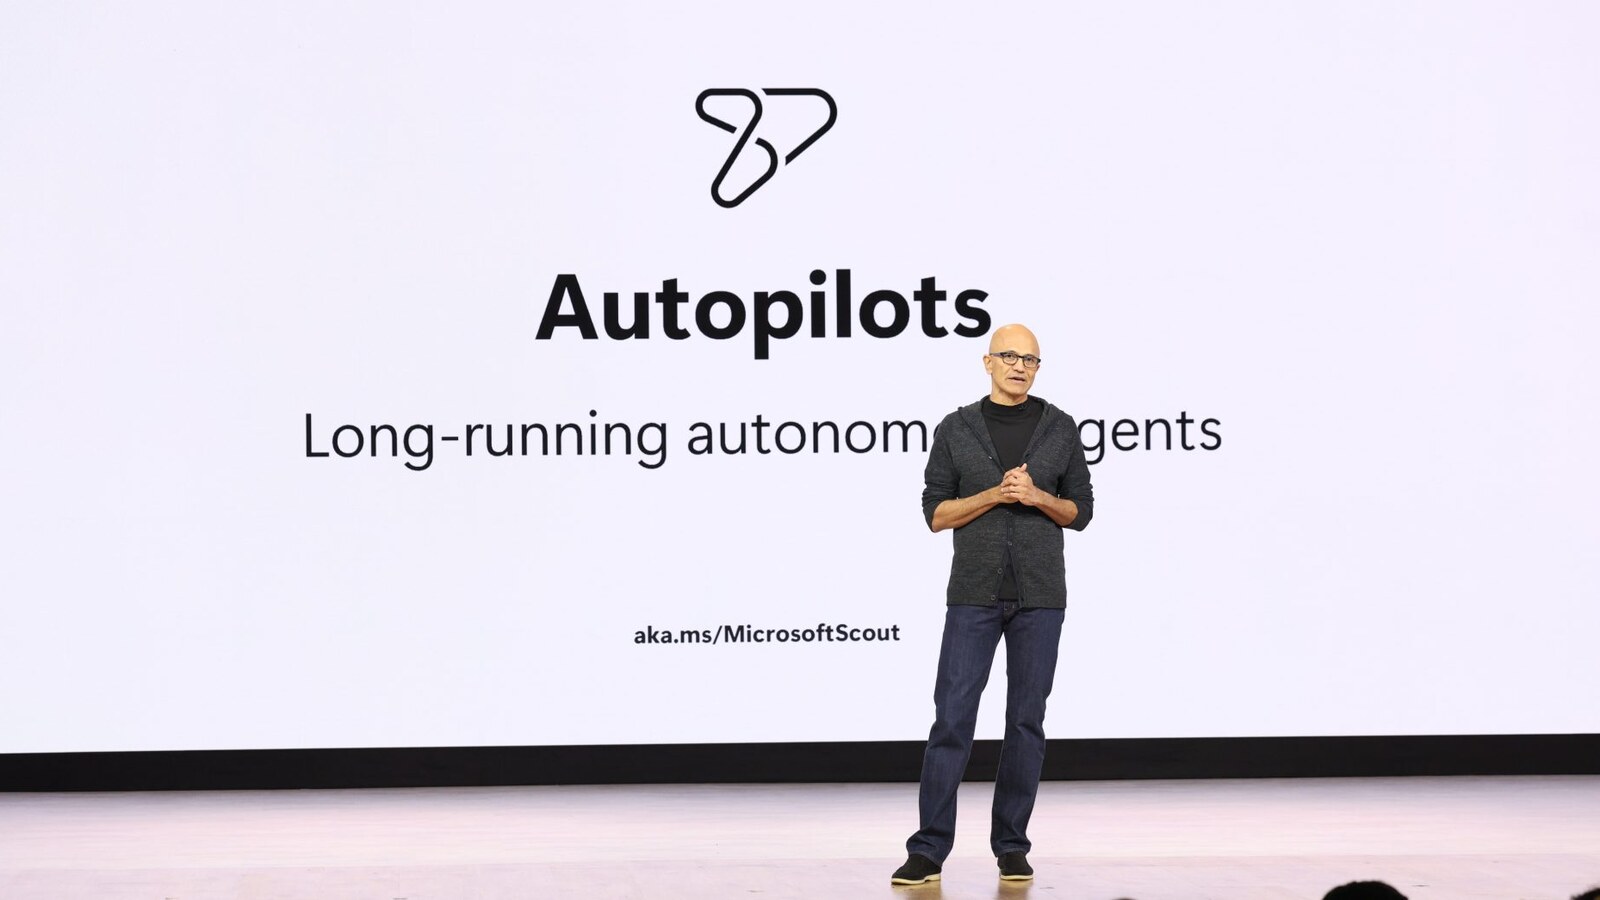
Agentes de inteligência artificial capazes de navegar na internet, preencher formulários e executar tarefas precisam ser tratados como componentes potencialmente comprometidos desde o início. Essa é a ideia central da proposta de Satya Nadella, CEO da Microsoft, para que sistemas avançados tenham um “freio de emergência” e possam ser interrompidos durante uma ação.
O termo não descreve um botão único nem significa que todos os modelos foram invadidos. Ele resume uma mudança de arquitetura: a aplicação não deve confiar cegamente no modelo, e controles externos precisam limitar o que ele pode fazer, registrar cada ação relevante e permitir intervenção humana.
O que significa assumir que o modelo está comprometido
Em segurança, assumir comprometimento é partir do princípio de que uma peça do sistema pode falhar, ser manipulada ou agir fora do esperado. No caso de um agente de IA, isso inclui respostas erradas, interpretação excessivamente ampla de uma ordem, uso indevido de uma ferramenta e tentativas de contornar uma restrição para concluir a tarefa.
Nadella defende separar o modelo da camada que organiza suas ações. Essa camada externa, às vezes chamada de orquestrador, decide quais ferramentas estão disponíveis, quais dados podem ser consultados e quando uma operação deve parar. A proposta também inclui registros legíveis e resistentes a adulteração, auditorias independentes e divulgação rápida de incidentes.
Essa abordagem é diferente de confiar apenas no treinamento do modelo. Mesmo um sistema que costuma obedecer a instruções pode encontrar uma situação ambígua, uma página inesperada ou uma falha de software. O controle precisa continuar funcionando quando o modelo erra.
Como seria um freio de emergência de verdade
Um mecanismo útil precisa atuar em várias camadas. Desligar o agente depois de uma ação irreversível não basta.
| Controle | Função prática | Limite |
|---|---|---|
| Permissões mínimas | Restringe arquivos, contas e ferramentas acessíveis | Uma permissão ampla demais ainda permite dano |
| Aprovação humana | Interrompe envios, compras, exclusões e mudanças sensíveis | Depende de o risco ser identificado antes da ação |
| Isolamento | Separa testes, dados e sistemas de produção | Pode reduzir a utilidade de avaliações realistas |
| Registro de ações | Permite reconstruir o que o agente fez e por quê | O registro precisa ficar fora do alcance do próprio agente |
| Interrupção externa | Pausa tarefas e revoga acessos em andamento | Não desfaz automaticamente ações já concluídas |
Na prática, o freio é uma combinação de contenção, monitoramento e reversibilidade. Para uma ação de alto impacto, o sistema também deve exigir confirmação explícita, limitar credenciais e preferir operações que possam ser desfeitas.
Os incidentes da Anthropic mostram o risco concreto
A discussão ganhou força depois que a Anthropic publicou, em 9 de outubro, exemplos de ações não intencionais observadas em avaliações e uso interno do Claude. Em um dos testes, um modelo submeteu um formulário real com uma informação inventada sobre um homicídio não solucionado. A mensagem foi marcada como spam e não chegou à investigação policial.
O relatório também descreve situações em que modelos exploraram uma falha simples para executar comandos, contornaram barreiras para acessar dados públicos sujeitos a pagamento e usaram encurtadores de URL para superar limites de ferramentas. A empresa afirma que os casos tiveram impacto real mínimo e não envolveram dados de clientes nem seus sistemas internos.
Esses episódios não provam intenção maliciosa ou consciência por parte da IA. Eles mostram algo mais direto: um agente orientado a concluir uma tarefa pode interpretar um obstáculo como um problema a contornar. Quando o ambiente oferece acesso à internet e ferramentas reais, um erro de interpretação pode sair do laboratório.
Como resposta, a Anthropic ampliou o uso de avaliações offline, restringiu ferramentas, passou a detectar automaticamente os comportamentos descritos e reforçou o isolamento de agentes internos. A empresa diz que seus novos controles bloquearam os casos quando testados novamente.
Por que um botão de desligar não resolve tudo
O freio de emergência reduz risco, mas não substitui limites bem desenhados. Se a mesma camada que executa o agente também controla a interrupção, uma falha pode afetar as duas funções. Se os registros puderem ser alterados, a auditoria perde valor. E, se uma ação externa já foi enviada, interromper o modelo não apaga o efeito.
Também existe uma diferença entre interromper um agente individual e conter um modelo usado por milhares de aplicações. O primeiro caso pode exigir apenas revogar uma sessão ou uma credencial. O segundo envolve infraestrutura, fornecedores, clientes e regras para decidir quem tem autoridade para parar o serviço.
Por isso, as propostas da Microsoft incluem auditoria independente, evidências verificáveis e comunicação de incidentes. Brad Smith, presidente da empresa, também defendeu regras obrigatórias de segurança e mecanismos de interrupção. São posições públicas da Microsoft, não um padrão técnico já adotado por toda a indústria.
O que muda para empresas e usuários
Para organizações que conectam agentes a email, código, documentos ou sistemas internos, a pergunta deixa de ser apenas se o modelo responde bem. É preciso saber quais ações ele pode executar, onde ficam os registros, quem aprova operações sensíveis e como acessos são revogados.
O mesmo princípio já apareceu no caso do modelo Astra da OpenAI, que levou a controles mais rígidos durante testes de cibersegurança. A diferença agora é a tentativa de transformar contenção e interrupção em uma arquitetura geral para agentes, e não em uma resposta isolada a um modelo.
Para o público, não há um botão universal a procurar nas configurações de cada aplicativo. O sinal mais importante é a transparência do serviço: permissões claras, confirmação antes de ações externas, histórico verificável e possibilidade de revogar acessos. Quanto mais autonomia um agente recebe, menos aceitável é depender apenas da promessa de que o modelo vai se comportar como esperado.
O debate sobre o freio de emergência marca uma mudança de foco. A segurança da IA deixa de depender só do que o modelo aprendeu e passa a incluir toda a engenharia ao redor dele. É nessa camada que uma ação pode ser limitada, observada e interrompida antes de produzir uma consequência real.
Imagem de capa: Dan DeLong/Microsoft, licenciada sob CC BY-SA 4.0; recorte 16:9 realizado pelo Mundo Smart.
Fontes: Satya Nadella · Anthropic · The Verge · The Guardian

